
- 30 giorni gratis! Inizia oggi senza costi
- Diventa partner
- Chiama ora (+44)-123-561-9426

Modelli di GPU disponibili
| Modello | Ideale per | VRAM | Passthrough | Casi d'uso tipici | Note |
|---|---|---|---|---|---|
| NVIDIA L4 | Inferenza AI/ML, codifica video | 24GB | Sì | Inferenza LLM, elaborazione multimediale, servizi API | Eccellente efficienza e rapporto qualità-prezzo |
| NVIDIA L40S | Rendering, visualizzazione 3D | 48GB | Sì | Blender, Unreal Engine, visualizzazione in tempo reale | Potente per AI visiva e rendering |
| RTX 6000 Ada (PRO) | CAD, animazione, applicazioni professionali | 48GB | Sì | Autodesk, SolidWorks, Adobe | Driver professionali, elevata stabilità |
| NVIDIA RTX PRO 6000 | Inferenza AI, rendering, visualizzazione professionale | 96GB GDDR7 | Sì | Inferenza LLM, AI generativa, rendering in tempo reale | Scheda di classe workstation con molta memoria |
| NVIDIA A16 | VDI e ambienti multiutente | 64GB (4x16GB) | Sì | Desktop virtuali, ambienti condivisi | Ottimizzata per la virtualizzazione multisessione |
| NVIDIA H100 | Addestramento di modelli AI, HPC | 80GB | Sì | Addestramento/fine-tuning di LLM, calcolo scientifico | Prestazioni di altissimo livello per l'addestramento AI |
| NVIDIA H200 | Addestramento LLM avanzato, HPC ad alta memoria | ~141GB | Sì | Modelli enormi, grandi dataset in memoria | Più VRAM per addestramento/inferenza intensivi |
| NVIDIA B300 | Modelli più grandi, inferenza e addestramento su scala di frontiera | 288GB | Sì | Modelli da trilioni di parametri, serving multimodello | La memoria più alta della nostra gamma |
Prezzi: NVIDIA RTX PRO 6000 da 1,50 $/ora e NVIDIA H200 da 2,50 $/ora, con fatturazione mensile. Per le altre GPU, contatta il nostro team per un preventivo.
GPU NVIDIA enterprise
Scegli tra L4, L40S, RTX 6000 Ada, RTX PRO 6000, A16, H100, H200 e B300: GPU ottimizzate per AI, rendering e machine learning.
Infrastruttura pronta per l'AI
Ambienti preconfigurati con TensorFlow, PyTorch e CUDA. Inizia ad addestrare modelli in pochi minuti, senza installazioni complesse.
Storage NVMe veloce
Lo storage NVMe Gen 5 ad alta banda garantisce che i dati arrivino alla GPU senza colli di bottiglia.
Prezzi GPU flessibili
Orario o mensile: scegli il modello più adatto. Scala le risorse GPU in tempo reale e paga solo ciò che usi.
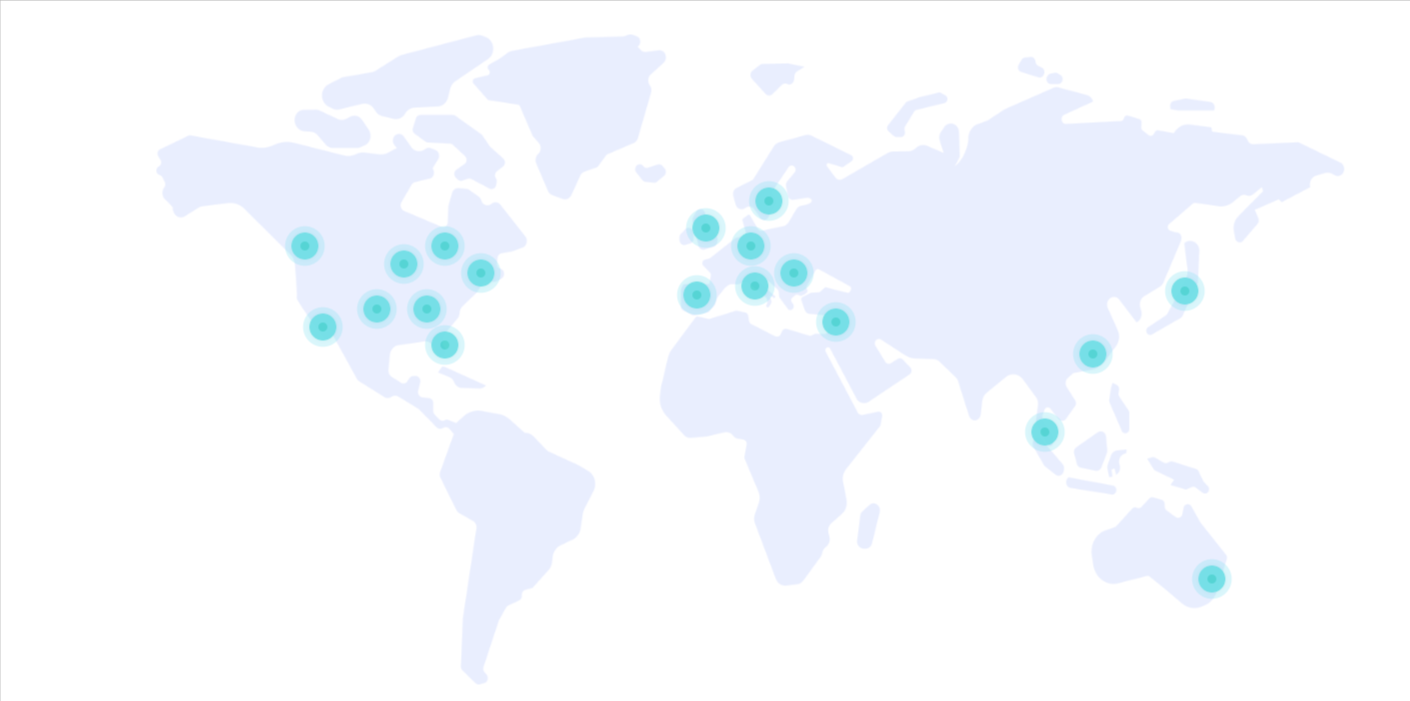
25 data center nel mondo
Esegui i carichi di lavoro GPU vicino ai tuoi utenti, con la possibilità di attivarli in 25 data center nel mondo.
Supporto esperto 24/7
Esperti di GPU e AI disponibili 24/7 per aiutarti a ottimizzare i carichi di lavoro e risolvere i problemi.
I nostri vantaggi
GPU NVIDIA enterprise per ogni carico di lavoro
Scegli tra una gamma di GPU enterprise, tra cui L4, L40S, RTX 6000 Ada, RTX PRO 6000, A16, H100, H200 e B300. Ogni GPU è ottimizzata per addestramento AI, inferenza di machine learning, rendering in tempo reale ed elaborazione video, con VRAM e core CUDA dedicati.
Infrastruttura pronta per l'AI con stack preconfigurati
I nostri server GPU includono ambienti AI preconfigurati con TensorFlow, PyTorch e driver CUDA. Salta le installazioni complesse: inizia ad addestrare i modelli in pochi minuti, non in giorni. Pieno supporto per l'addestramento distribuito su più GPU.
Throughput elevato con storage NVMe
Ogni server GPU abbina uno storage NVMe Gen 5 ultraveloce a una connettività ad alta larghezza di banda, così i dati raggiungono la GPU senza colli di bottiglia. Ideale per addestrare modelli di grandi dimensioni ed elaborare flussi di dati in tempo reale con una latenza di I/O minima.
Prezzi flessibili: paghi solo ciò che usi
Scegli tra tariffa oraria o mensile in base alle tue esigenze. Aumenta e riduci le risorse GPU in tempo reale, così non paghi mai capacità inutilizzata. Perfetto per carichi di lavoro a picchi, progetti di ricerca e deployment AI in produzione.

Scelto in tutto il mondo
Oltre 30 anni di esperienza, decine di migliaia di clienti e una presenza globale che parla da sé.
0
Clienti
0
Anni di esperienza
0
Paesi
0
Server
Scelto da aziende leader
Piani e prezzi
Scegli la configurazione cloud adatta alla tua azienda, con prestazioni, disponibilità e flessibilità.
| Piano | Prezzo mensile | Core CPU | Memoria (GB) | Spazio disco (GB) | Traffico dati (GB) |
|---|---|---|---|---|---|
| Availability 1GB 1core | $4.00 | 1 | 1.0 | 20 | 5000 |
| Availability 2GB 1 core | $6.00 | 1 | 2.0 | 20 | 5000 |
| General 1GB 1 core | $9.00 | 1 | 1.0 | 20 | 5000 |
| General 2GB 1 core | $15.00 | 1 | 2.0 | 20 | 5000 |
| Availability 4GB 2 cores | $19.00 | 2 | 4.0 | 40 | 5000 |
| General 4GB 2 cores | $42.00 | 2 | 4.0 | 40 | 5000 |
| Availability 8GB 4 cores | $42.00 | 4 | 8.0 | 80 | 5000 |
| General 8GB 4 cores | $90.00 | 4 | 8.0 | 80 | 5000 |
| Availability 16GB 8 cores | $99.00 | 8 | 16.0 | 150 | 5000 |
Conformità e standard
Sicurezza delle informazioni, governance e controlli operativi sono parte integrante dei nostri servizi.
ISO/IEC 27001
27001
Gestione della sicurezza delle informazioni a livello aziendale, secondo uno standard internazionale.
ISO/IEC 27017
27017
Controlli di sicurezza specifici per ambienti e servizi cloud.
SOC 2
SOC 2
Controlli e processi operativi incentrati su sicurezza, disponibilità e gestione dei servizi.
Domande frequenti
Sì, il nostro team di supporto tecnico è disponibile 24/7 per aiutarti con configurazione, risoluzione dei problemi e ottimizzazione.
Le nostre GPU sono ospitate nella nostra rete globale di data center, per garantire bassa latenza e alta disponibilità.
Non necessariamente. Mettiamo a disposizione template pronti all'uso e il nostro team di supporto è disponibile 24/7 per aiutarti a configurare il tuo ambiente.
Attivazione in giornata.
Le nostre GPU cloud supportano framework AI (TensorFlow, PyTorch, Keras), software di rendering 3D, piattaforme CAD, ambienti VDI e altro ancora.
Sì. Puoi passare facilmente a un altro modello di GPU o aumentare le risorse in qualsiasi momento.
- L4 - Ideale per inferenza AI, ML e carichi di lavoro leggeri - RTX PRO 6000 (96GB) - Inferenza LLM fino a ~70B quantizzati, AI generativa e rendering - H200 (141GB) - Modelli di classe 70B con contesto lungo, training AI di fascia alta e HPC - B300 (288GB) - I modelli più grandi, modelli 70B a 16 bit e serving multi-modello - L40S - Ottima per rendering, visualizzazione e carichi di lavoro 3D - A16 - Ideale per VDI e configurazioni multiutente - RTX 6000 Ada - Grafica professionale, CAD e animazione
Passthrough significa che la GPU è interamente dedicata alla tua macchina virtuale, senza condivisione delle risorse. Questo garantisce massime prestazioni, stabilità e compatibilità con le applicazioni che richiedono un accesso diretto alla GPU.
Offriamo un prezzo mensile fisso per ogni modello di GPU. Nessun costo nascosto né addebito a consumo: paghi ogni mese un importo unico e prevedibile.
Una GPU cloud è un'unità di elaborazione grafica dedicata, ospitata nei nostri data center cloud. Hai accesso completo in passthrough alla GPU fisica, come se fosse tua, ma con la flessibilità della fatturazione cloud e dell'attivazione immediata.
Server GPU cloud: massime prestazioni per AI, ML e rendering
I server GPU cloud sono progettati per i carichi di lavoro più impegnativi: dall'addestramento AI e dal machine learning al rendering 3D, alla progettazione CAD e al calcolo scientifico. Su OMC Cloud offriamo GPU NVIDIA dedicate con accesso passthrough completo, per garantire le massime prestazioni alle tue applicazioni.
Un'infrastruttura GPU potente
La nostra infrastruttura GPU cloud utilizza l'hardware NVIDIA più recente, inclusi i modelli L4, L40S, RTX 6000 Ada, RTX PRO 6000, A16, H100, H200 e B300. Ogni GPU è interamente dedicata al tuo carico di lavoro: nessuna condivisione, nessun throttling, nessun compromesso.
Flessibile in ogni fase
Che tu sia una startup alle prime sperimentazioni di ML o un'azienda che addestra grandi modelli linguistici, le nostre istanze GPU crescono con le tue esigenze. Parti con una singola GPU per lo sviluppo e passa a cluster multi-GPU per i carichi di produzione.
Perché scegliere il GPU cloud di OMC?
Passthrough completo: accesso diretto alle GPU NVIDIA per le massime prestazioni.
Fatturazione flessibile: prezzo mensile fisso oppure orario on demand: paghi solo ciò che usi.
Disponibilità globale: attiva server GPU nei nostri 25 data center nel mondo.
Supporto esperto 24/7: i nostri specialisti cloud sono disponibili a qualsiasi ora per aiutarti.
SLA di uptime del 99.95%: affidabilità di livello enterprise garantita dal nostro accordo sul livello di servizio.
Hai una domanda? I nostri esperti cloud sono felici di aiutarti: chiamaci al (+44) 123-561-9426
