Quanto costa eseguire un modello di AI in produzione? (2026)
Pubblicato:
AI

In breve: eseguire un modello di AI in produzione costa quanto le ore di GPU, divise per il numero di token utili che ne ottieni. Una GPU dedicata occupata per gran parte della giornata di solito costa meno per token di un'API a pagamento per token; una che resta inattiva quasi tutto il giorno non lo è quasi mai. I tre numeri che determinano la tua bolletta sono la GPU di cui hai bisogno (stabilita dall'ingombro in memoria del modello), il suo prezzo orario e il suo utilizzo.
Per anni la parte costosa dell'AI è stata l'addestramento. Ora la situazione si è ribaltata. Nell'agosto 2026 Gartner ha previsto che la spesa per infrastrutture cloud ottimizzate per l'AI raggiungerà 42 miliardi di $ nel 2026, in crescita del 96%, e che l'inferenza (23.3 miliardi di $) supererà per la prima volta l'addestramento (19 miliardi di $). Si prevede che l'inferenza rappresenti il 55% di questa spesa nel 2026 e il 59% nel 2027. Il motivo è semplice: un modello viene addestrato una volta, ma risponde a domande ogni secondo in cui è in produzione, e i flussi di lavoro agentici effettuano molte chiamate al modello per ogni richiesta dell'utente.
1. La memoria, che determina la GPU. I pesi del modello devono entrare nella memoria della GPU, lasciando spazio per la KV cache che contiene il contesto di ogni conversazione. Una regola approssimativa: parametri moltiplicati per i byte per parametro. Con precisione a 16 bit sono 2 byte per parametro, in FP8 è 1 byte, a 4 bit circa mezzo byte.
2. Il prezzo orario di quella GPU. Più memoria costa di più all'ora. Scegliere la GPU più piccola che contiene il modello con contesto sufficiente è il risparmio più grande in assoluto.
3. Il throughput. Quanti token al secondo produce la GPU per tutti gli utenti contemporaneamente. Software di serving come vLLM o TensorRT-LLM raggruppano molte richieste, quindi il throughput aggregato è molto più alto della velocità percepita da un singolo utente.
4. L'utilizzo. La quota di ore pagate in cui la GPU svolge lavoro utile. È qui che la maggior parte dei budget si disperde.
La formula è: costo per milione di token = prezzo orario della GPU / (token al secondo x 3.600) x 1.000.000 / utilizzo.
Un esempio con numeri indicativi (non un prezzo OMC): una GPU da 2,00 $ all'ora che produce 1.000 token al secondo per tutti gli utenti genera 3,6 milioni di token all'ora. Con utilizzo pieno sono circa 0,56 $ per milione di token. Con un utilizzo del 25%, lo stesso server costa circa 2,22 $ per milione di token, quattro volte tanto, perché paghi anche le ore di inattività. Se la usi ininterrottamente, quella GPU costa circa 1.460 $ al mese (730 ore).
Un'API a pagamento per token non ha costi di inattività, il che la rende la scelta giusta per prototipi, traffico irregolare e bassi volumi. Una GPU dedicata ha un costo mensile fisso, che la rende più conveniente quando i volumi sono alti e costanti. Per trovare il punto di pareggio, dividi il costo mensile del server GPU per il prezzo dell'API per milione di token. Se prevedi di elaborare più token di quel valore ogni mese, il self-hosting conviene.
Il costo non è l'unico motivo per cui i team passano a GPU proprie. Con un server dedicato, prompt e dati non lasciano mai il tuo ambiente, il che conta per i settori regolamentati e per il GDPR. Puoi anche eseguire modelli fine-tuned o open-weight che le API non offrono, e la latenza resta prevedibile perché nessun altro condivide la scheda.
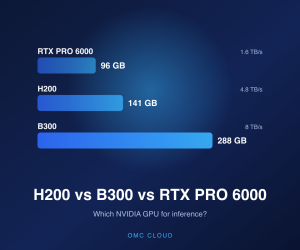
OMC Cloud noleggia GPU NVIDIA dedicate con passthrough completo, con fatturazione oraria o mensile: L4 (24 GB), L40S (48 GB), RTX PRO 6000 (96 GB GDDR7), H100 (80 GB), H200 (141 GB) e B300 (288 GB). I server arrivano con CUDA, PyTorch e TensorFlow pronti, girano in 25 data center e includono uno SLA di uptime del 99.95% e supporto umano 24/7. Visita la pagina GPU cloud, confronta le schede nella nostra guida H200 vs B300 vs RTX PRO 6000 o leggi i casi d'uso per l'inferenza LLM.
Fonti: comunicato stampa Gartner sulla spesa per IaaS ottimizzate per l'AI, 10 agosto 2026; specifiche di prodotto NVIDIA per H200, B300 e RTX PRO 6000.
Unisciti alle decine di migliaia di clienti che ogni giorno si affidano a OMC
Registrandoti accetti i termini di servizio
Ricevi un preventivo personalizzato entro mezz’ora
Registrandoti accetti i termini di servizio
2025 OMC, Inc., tutti i diritti riservati