
- 30 Tage kostenlos! Starten Sie noch heute gratis
- Partner werden
- Jetzt anrufen (+44)-123-561-9426

Verfügbare GPU-Modelle
| Modell | Ideal für | VRAM | Passthrough | Typische Anwendungsfälle | Hinweise |
|---|---|---|---|---|---|
| NVIDIA L4 | KI/ML-Inferenz, Video-Encoding | 24GB | Ja | LLM-Inferenz, Medienverarbeitung, API-Dienste | Hervorragende Effizienz und Preis-Leistung |
| NVIDIA L40S | Rendering, 3D-Visualisierung | 48GB | Ja | Blender, Unreal Engine, Echtzeitvisualisierung | Leistungsstark für visuelle KI und Rendering |
| RTX 6000 Ada (PRO) | CAD, Animation, professionelle Anwendungen | 48GB | Ja | Autodesk, SolidWorks, Adobe | Professionelle Treiber, hohe Stabilität |
| NVIDIA RTX PRO 6000 | KI-Inferenz, Rendering, professionelle Visualisierung | 96GB GDDR7 | Ja | LLM-Inferenz, generative KI, Echtzeit-Rendering | Karte der Workstation-Klasse mit großem Speicher |
| NVIDIA A16 | VDI und Mehrbenutzerumgebungen | 64GB (4x16GB) | Ja | Virtuelle Desktops, gemeinsam genutzte Umgebungen | Optimiert für Virtualisierung mit mehreren Sitzungen |
| NVIDIA H100 | Training von KI-Modellen, HPC | 80GB | Ja | Training/Fine-Tuning von LLMs, wissenschaftliches Rechnen | Spitzenleistung für KI-Training |
| NVIDIA H200 | Anspruchsvolles LLM-Training, HPC mit hohem Speicherbedarf | ~141GB | Ja | Sehr große Modelle, große In-Memory-Datensätze | Mehr VRAM für anspruchsvolles Training und Inferenz |
| NVIDIA B300 | Größte Modelle, Inferenz und Training im Frontier-Maßstab | 288GB | Ja | Modelle mit Billionen Parametern, Serving mehrerer Modelle | Größter Speicher in unserem Angebot |
Preise: NVIDIA RTX PRO 6000 ab $1,50/Stunde und NVIDIA H200 ab $2,50/Stunde bei monatlicher Abrechnung. Für andere GPUs erhalten Sie von unserem Team ein Angebot.
NVIDIA-Enterprise-GPUs
Wählen Sie aus L4, L40S, RTX 6000 Ada, RTX PRO 6000, A16, H100, H200 und B300: GPUs, optimiert für KI, Rendering und Machine Learning.
KI-fähige Infrastruktur
Vorkonfigurierte Umgebungen mit TensorFlow, PyTorch und CUDA. Beginnen Sie in wenigen Minuten mit dem Training von Modellen, ohne aufwendige Installationen.
Schneller NVMe-Storage
Gen-5-NVMe-Storage mit hoher Bandbreite sorgt dafür, dass Daten ohne Engpässe zur GPU gelangen.
Flexible GPU-Preise
Stündlich oder monatlich: Wählen Sie das passende Modell. Skalieren Sie GPU-Ressourcen in Echtzeit und zahlen Sie nur, was Sie nutzen.
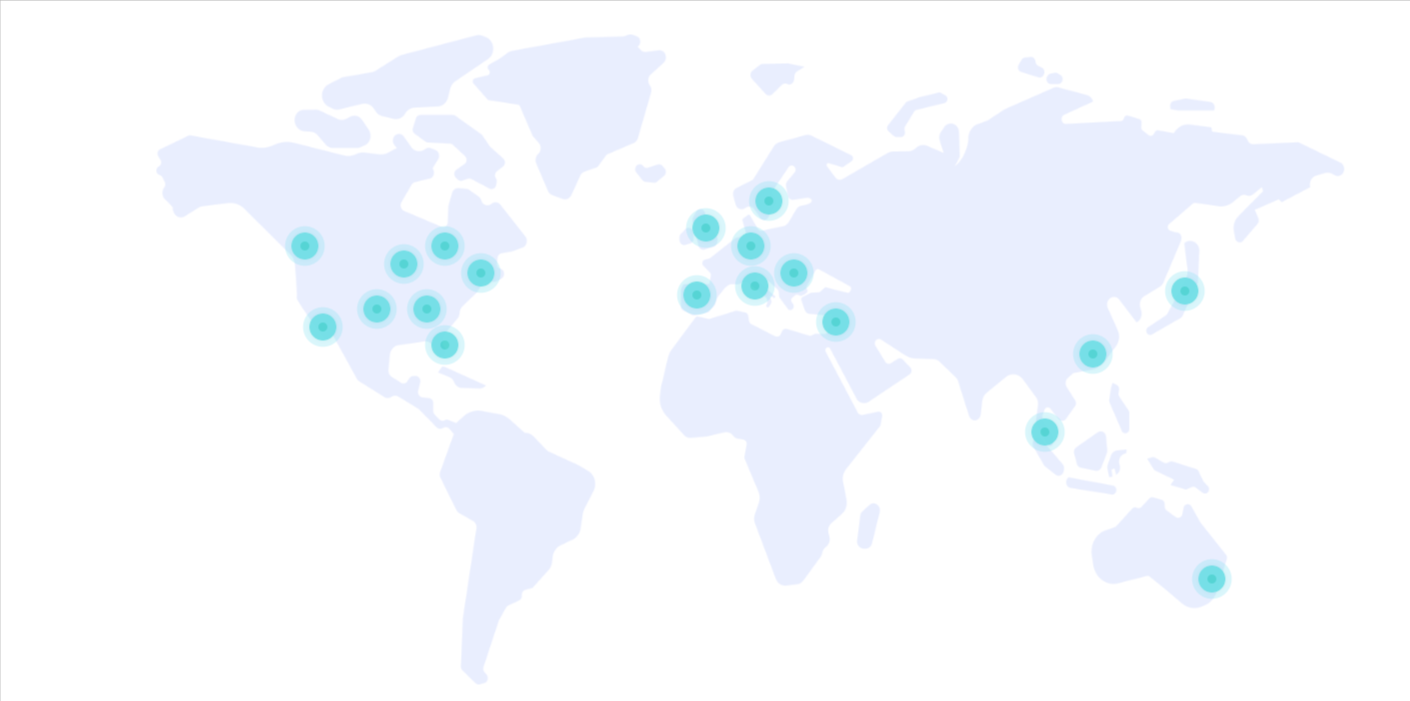
25 Rechenzentren weltweit
Betreiben Sie GPU-Workloads nahe an Ihren Nutzern, mit Bereitstellung in 25 Rechenzentren weltweit.
24/7-Expertensupport
GPU- und KI-Experten stehen Ihnen 24/7 zur Verfügung, um Workloads zu optimieren und Probleme zu lösen.
Unsere Vorteile
Enterprise-GPUs von NVIDIA für jeden Workload
Wählen Sie aus einer Reihe von Enterprise-GPUs, darunter L4, L40S, RTX 6000 Ada, RTX PRO 6000, A16, H100, H200 und B300. Jede GPU ist mit dediziertem VRAM und CUDA-Kernen für KI-Training, Machine-Learning-Inferenz, Echtzeit-Rendering und Videoverarbeitung optimiert.
KI-fähige Infrastruktur mit vorkonfigurierten Stacks
Unsere GPU-Server werden mit vorkonfigurierten KI-Umgebungen einschließlich TensorFlow, PyTorch und CUDA-Treibern ausgeliefert. Sparen Sie sich komplexe Installationen – trainieren Sie Modelle in Minuten statt Tagen. Volle Unterstützung für verteiltes Training über mehrere GPUs.
Hoher Durchsatz mit NVMe-Storage
Jeder GPU-Server kombiniert ultraschnellen Gen 5 NVMe-Storage mit Konnektivität hoher Bandbreite, sodass die Daten ohne Engpässe zur GPU gelangen. Ideal für das Training großer Modelle und die Verarbeitung von Echtzeit-Datenströmen mit minimaler I/O-Latenz.
Flexible Preise – zahlen Sie nur, was Sie nutzen
Wählen Sie je nach Bedarf zwischen stündlicher und monatlicher Abrechnung. Skalieren Sie GPU-Ressourcen in Echtzeit hoch und herunter, damit Sie nie für ungenutzte Kapazität bezahlen. Ideal für Lastspitzen, Forschungsprojekte und produktive KI-Deployments.

Weltweit im Einsatz
Über 30 Jahre Erfahrung, Zehntausende Kunden und eine globale Präsenz, die für sich spricht.
0
Kunden
0
Jahre Erfahrung
0
Länder
0
Server
Vertrauen von führenden Unternehmen
Tarife und Preise
Wählen Sie die passende Cloud-Konfiguration für Ihr Unternehmen, mit Leistung, Verfügbarkeit und Flexibilität.
| Tarif | Monatspreis | CPU-Kerne | Arbeitsspeicher (GB) | Speicherplatz (GB) | Datentransfer (GB) |
|---|---|---|---|---|---|
| Availability 1GB 1core | $4.00 | 1 | 1.0 | 20 | 5000 |
| Availability 2GB 1 core | $6.00 | 1 | 2.0 | 20 | 5000 |
| General 1GB 1 core | $9.00 | 1 | 1.0 | 20 | 5000 |
| General 2GB 1 core | $15.00 | 1 | 2.0 | 20 | 5000 |
| Availability 4GB 2 cores | $19.00 | 2 | 4.0 | 40 | 5000 |
| General 4GB 2 cores | $42.00 | 2 | 4.0 | 40 | 5000 |
| Availability 8GB 4 cores | $42.00 | 4 | 8.0 | 80 | 5000 |
| General 8GB 4 cores | $90.00 | 4 | 8.0 | 80 | 5000 |
| Availability 16GB 8 cores | $99.00 | 8 | 16.0 | 150 | 5000 |
Compliance und Standards
Informationssicherheit, Governance und betriebliche Kontrollen sind fester Bestandteil unserer Dienste.
ISO/IEC 27001
27001
Informationssicherheitsmanagement auf Unternehmensniveau nach einem internationalen Standard.
ISO/IEC 27017
27017
Sicherheitskontrollen speziell für Cloud-Umgebungen und Cloud-Dienste.
SOC 2
SOC 2
Betriebliche Kontrollen und Prozesse mit Fokus auf Sicherheit, Verfügbarkeit und Servicemanagement.
Häufige Fragen
Ja, unser technisches Support-Team steht Ihnen 24/7 bei Einrichtung, Fehlerbehebung und Optimierung zur Seite.
Unsere GPUs werden in unserem weltweiten Netz von Rechenzentren gehostet – für niedrige Latenz und hohe Verfügbarkeit.
Nicht unbedingt. Wir stellen sofort einsatzbereite Vorlagen bereit, und unser Support-Team hilft Ihnen 24/7 bei der Konfiguration Ihrer Umgebung.
Bereitstellung am selben Tag.
Unsere Cloud-GPUs unterstützen KI-Frameworks (TensorFlow, PyTorch, Keras), 3D-Rendering-Software, CAD-Plattformen, VDI-Umgebungen und mehr.
Ja. Sie können jederzeit problemlos auf ein anderes GPU-Modell wechseln oder Ressourcen erweitern.
- L4 – Ideal für KI-Inferenz, ML und leichte Workloads - RTX PRO 6000 (96GB) – LLM-Inferenz bis zu ~70B (quantisiert), generative KI und Rendering - H200 (141GB) – Modelle der 70B-Klasse mit langem Kontext, anspruchsvolles KI-Training und HPC - B300 (288GB) – Die größten Modelle, 70B-Modelle in 16-Bit und Multi-Model-Serving - L40S – Hervorragend für Rendering, Visualisierung und 3D-Workloads - A16 – Ideal für VDI und Mehrbenutzer-Setups - RTX 6000 Ada – Professionelle Grafik, CAD und Animation
Passthrough bedeutet, dass die GPU vollständig Ihrer virtuellen Maschine zugewiesen ist, ohne geteilte Ressourcen. Das gewährleistet maximale Leistung, Stabilität und Kompatibilität mit Anwendungen, die direkten GPU-Zugriff benötigen.
Wir bieten feste Monatspreise pro GPU-Modell. Es gibt keine versteckten Gebühren oder nutzungsabhängigen Kosten – Sie zahlen jeden Monat einen planbaren Betrag.
Eine Cloud-GPU ist ein dedizierter Grafikprozessor, der in unseren Cloud-Rechenzentren gehostet wird. Sie erhalten vollen Passthrough-Zugriff auf die physische GPU, als würde sie Ihnen gehören – jedoch mit der Flexibilität der Cloud-Abrechnung und sofortiger Bereitstellung.
GPU-Cloud-Server: Maximale Leistung für KI, ML & Rendering
GPU-Cloud-Server sind für die anspruchsvollsten Workloads ausgelegt, vom KI-Training und Machine Learning bis zu 3D-Rendering, CAD-Konstruktion und wissenschaftlichem Rechnen. Bei OMC Cloud stellen wir dedizierte NVIDIA-GPUs mit vollem Passthrough-Zugriff bereit und sorgen so für maximale Leistung Ihrer Anwendungen.
Leistungsstarke GPU-Infrastruktur
Unsere GPU-Cloud-Infrastruktur umfasst die neueste NVIDIA-Hardware, darunter die Modelle L4, L40S, RTX 6000 Ada, RTX PRO 6000, A16, H100, H200 und B300. Jede GPU steht vollständig Ihrer Workload zur Verfügung: kein Teilen, keine Drosselung, keine Kompromisse.
Flexibel für jede Phase
Ob Sie als Startup Ihre ersten ML-Experimente durchführen oder als Großunternehmen große Sprachmodelle trainieren: Unsere GPU-Instanzen wachsen mit Ihren Anforderungen. Beginnen Sie mit einer einzelnen GPU für die Entwicklung und skalieren Sie für produktive Workloads auf Multi-GPU-Cluster.
Warum die GPU-Cloud von OMC?
Voller Passthrough: Direkter Zugriff auf NVIDIA-GPUs für maximale Leistung.
Flexible Abrechnung: Feste Monatspreise oder stündlich nach Bedarf: Sie zahlen nur, was Sie nutzen.
Weltweite Verfügbarkeit: Stellen Sie GPU-Server in unseren 25 Rechenzentren weltweit bereit.
24/7-Expertensupport: Unsere Cloud-Spezialisten unterstützen Sie rund um die Uhr.
Uptime-SLA von 99,95 %: Zuverlässigkeit auf Enterprise-Niveau, abgesichert durch unser Service Level Agreement.
Haben Sie eine Frage? Unsere Cloud-Experten helfen Ihnen gern. Rufen Sie uns an unter (+44) 123-561-9426
